Selama beberapa tahun, pengalaman banyak orang dengan AI identik dengan kotak chat: kita menulis pertanyaan, lalu model menghasilkan paragraf, kode, atau ringkasan. Jev mencoba pekerjaan yang lebih sempit.
Alih-alih diminta menulis jawaban panjang, Jev menerima konteks dari software, mengevaluasi pertanyaan yang sudah ditentukan, lalu mengembalikan keputusan terstruktur beserta probabilitas atau confidence yang bisa dipakai aplikasi.
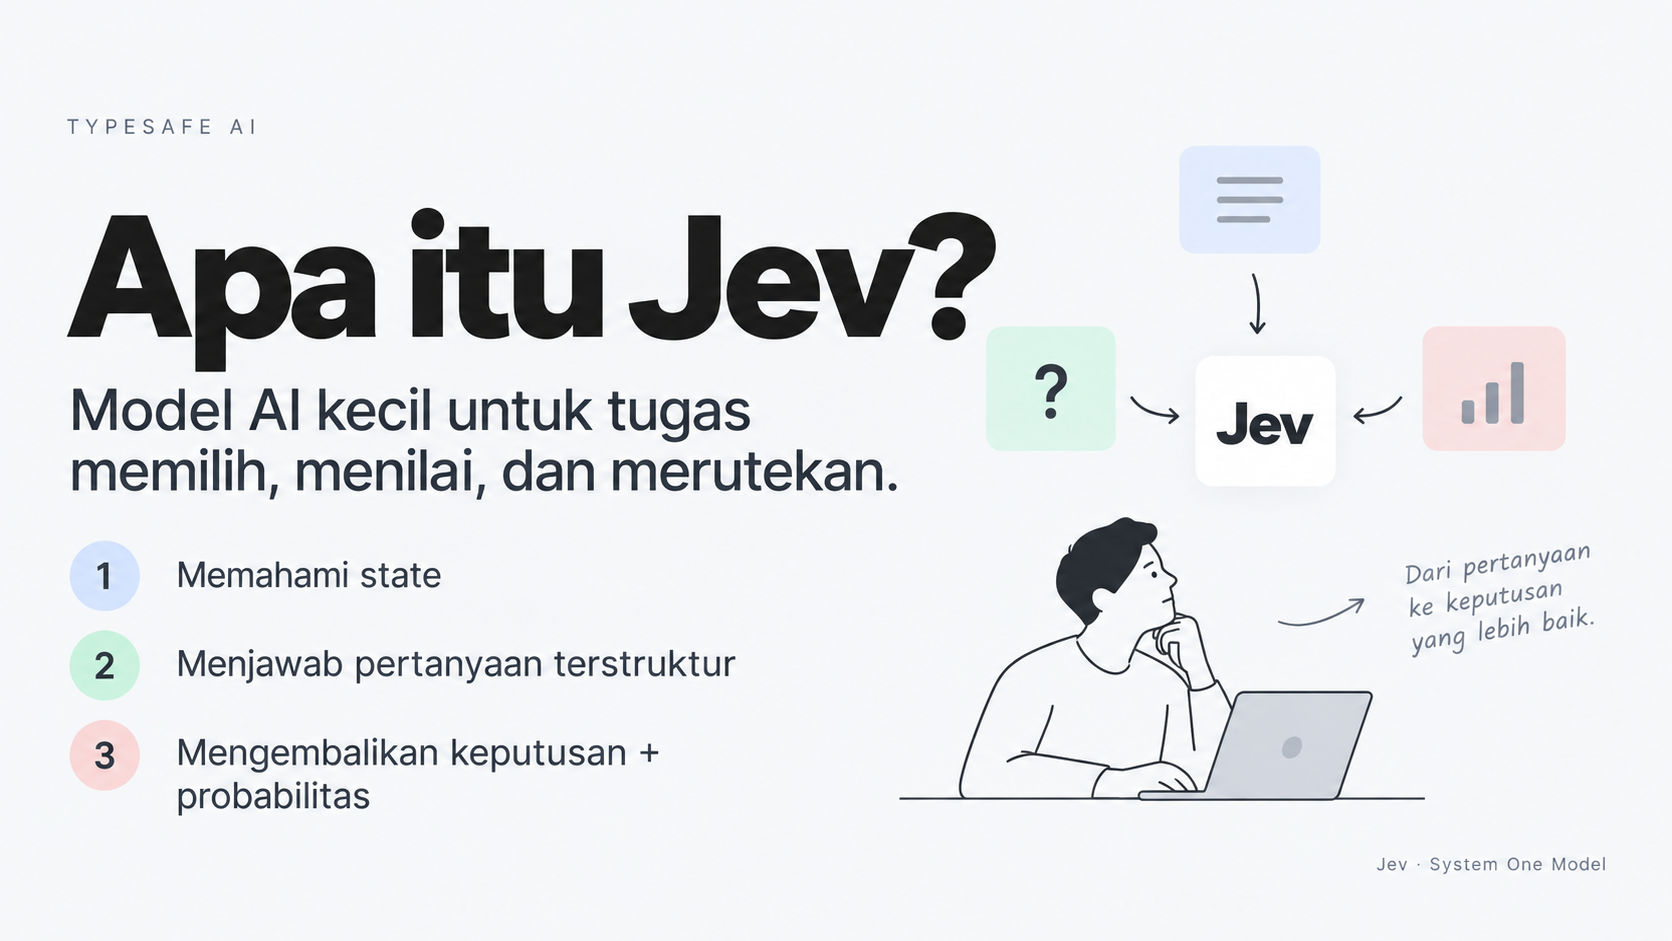
Gambaran paling singkatnya:
TypeSafe AI memperkenalkan Jev pada 15 September 2026 sebagai model publik pertama dalam kelas yang mereka sebut System One Models. Nama Jev merujuk pada ekonom William Stanley Jevons; Jev bukan singkatan dari “Judgement Evaluation Model” atau variasi sejenis.
#Apa itu Jev?
Bayangkan dua jenis permintaan.
Untuk LLM biasa, kita bisa berkata:
Jelaskan kenapa pelanggan ini marah dan tulis balasan yang sopan.
Model lalu menghasilkan teks.
Untuk Jev, pertanyaannya lebih seperti:
- tiket ini masuk ke departemen mana?
- seberapa tinggi tingkat frustrasinya?
- seberapa mungkin kasus ini urgent?
Pilihan jawaban, tipe data, dan bentuk output sudah ditentukan oleh aplikasi. Jev melakukan penilaian terhadap state yang diberikan dan mengembalikan hasil yang terstruktur.
Analogi sederhananya:
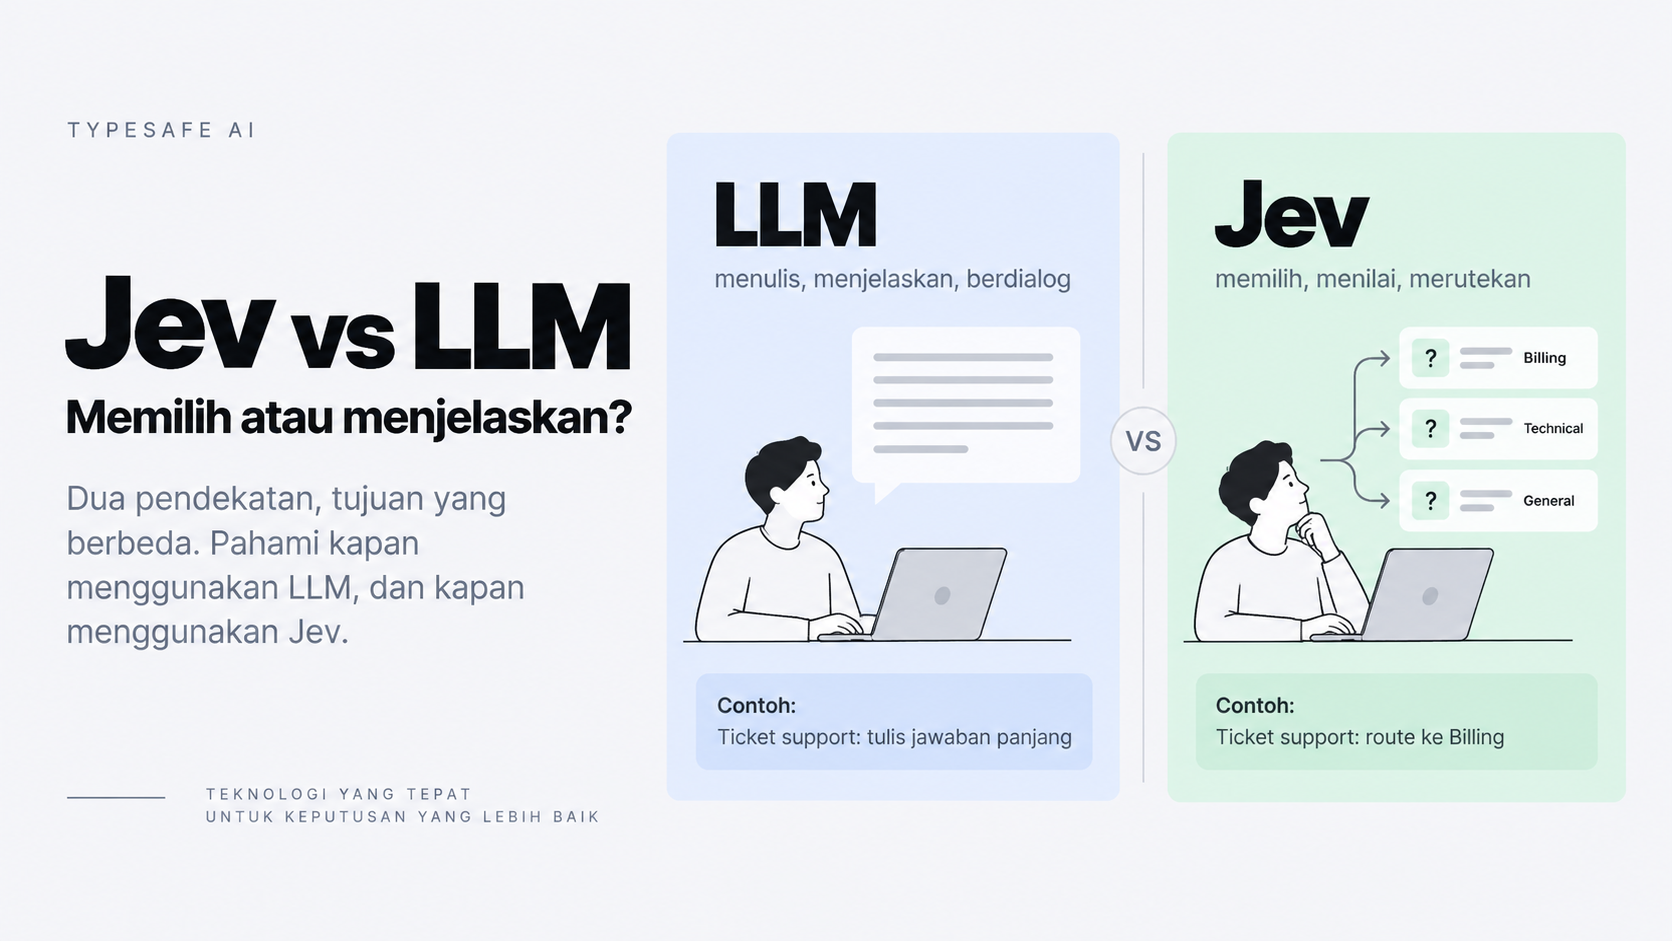
LLM seperti orang yang diminta menjelaskan situasi.
Jev seperti petugas triase yang diminta memilih dari opsi yang sudah tersedia dan memberi tingkat keyakinan.
Ini membuat Jev menarik untuk bagian software yang membutuhkan banyak keputusan kecil: routing, classification, scoring, gating, atau memilih tindakan berikutnya.
Jev bukan model untuk menulis artikel, melakukan percakapan panjang, atau membuat penjelasan bebas. Untuk pekerjaan seperti itu, LLM tetap lebih sesuai.
#Siapa yang membuat Jev?
Jev dibuat oleh TypeSafe AI. Pengumuman resminya ditulis oleh founder TypeSafe, Diogo Almeida, pada 15 September 2026.
TypeSafe memakai istilah System One Models untuk model yang berfokus pada keputusan terstruktur. Framing resmi mereka dapat diringkas sebagai: state yang tidak terstruktur masuk, lalu model menghasilkan keputusan probabilistik dengan tipe yang sudah diketahui software.
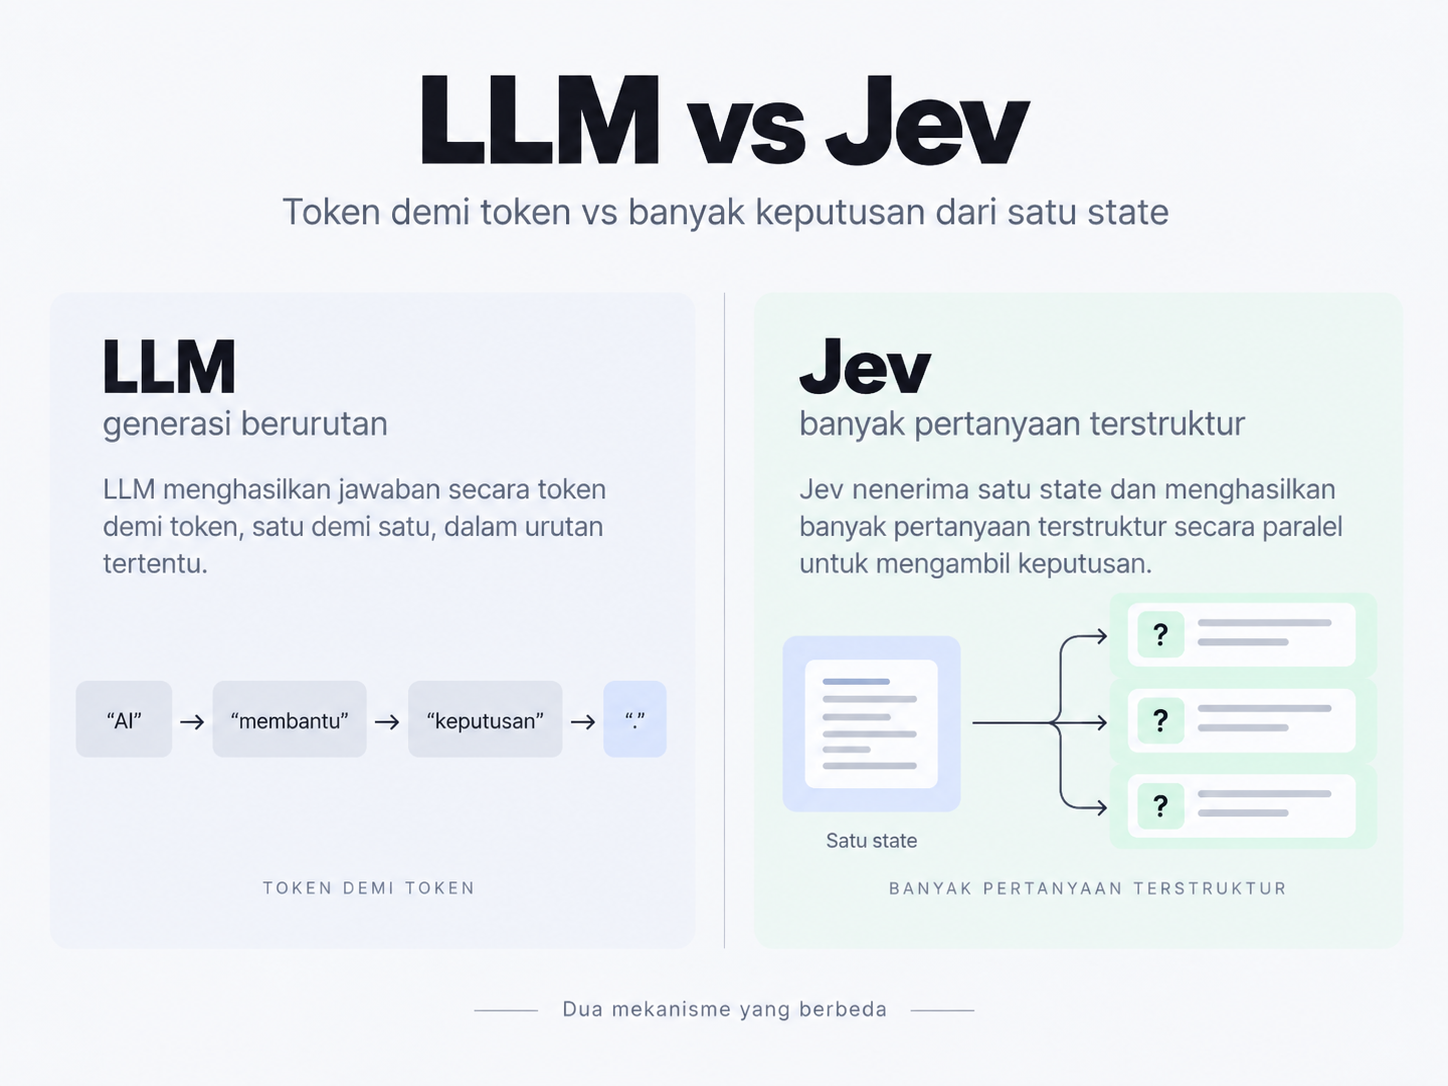
Ini berbeda dari LLM generatif yang biasanya menghasilkan token teks satu per satu.
#Kenapa Jev ramai dibicarakan minggu ini?
Ada beberapa peristiwa yang datang hampir bersamaan.
Pada 15 September 2026, TypeSafe memperkenalkan System One Models dan Jev. Sehari kemudian, 16 September, Vercel mengumumkan Jev tersedia melalui AI Gateway. Pada 18 September, Vercel juga menulis bahwa Jev menjadi salah satu model dengan adopsi awal paling cepat di AI Gateway mereka.
Yang membuat pembahasannya menarik bukan karena Jev “menggantikan ChatGPT”. Justru karena posisinya berbeda.
Banyak workflow software tidak membutuhkan paragraf. Mereka hanya membutuhkan jawaban seperti:
department = Billing
risk = 0.18
urgent_probability = 0.91
action = Escalate
Jika output akhirnya memang keputusan sempit seperti itu, model yang sejak awal dirancang untuk keputusan terstruktur menjadi pendekatan yang layak diuji.
TypeSafe juga mempublikasikan klaim latency dan biaya yang jauh lebih rendah dibanding beberapa LLM pada eval mereka sendiri. Angka tersebut sebaiknya dibaca sebagai hasil benchmark vendor pada workload dan kondisi yang mereka tentukan, bukan jaminan universal untuk semua aplikasi. Karena itu artikel ini tidak memakai angka tersebut sebagai dasar utama untuk memilih Jev.
#Cara kerja Jev secara intuitif
Alur dasarnya sederhana:
- aplikasi mengumpulkan state;
- developer mendefinisikan beberapa questions;
- Jev mengevaluasi pertanyaan tersebut terhadap state yang sama;
- aplikasi menerima hasil terstruktur beserta probabilitas atau confidence;
- code memutuskan apa yang harus dilakukan berikutnya.
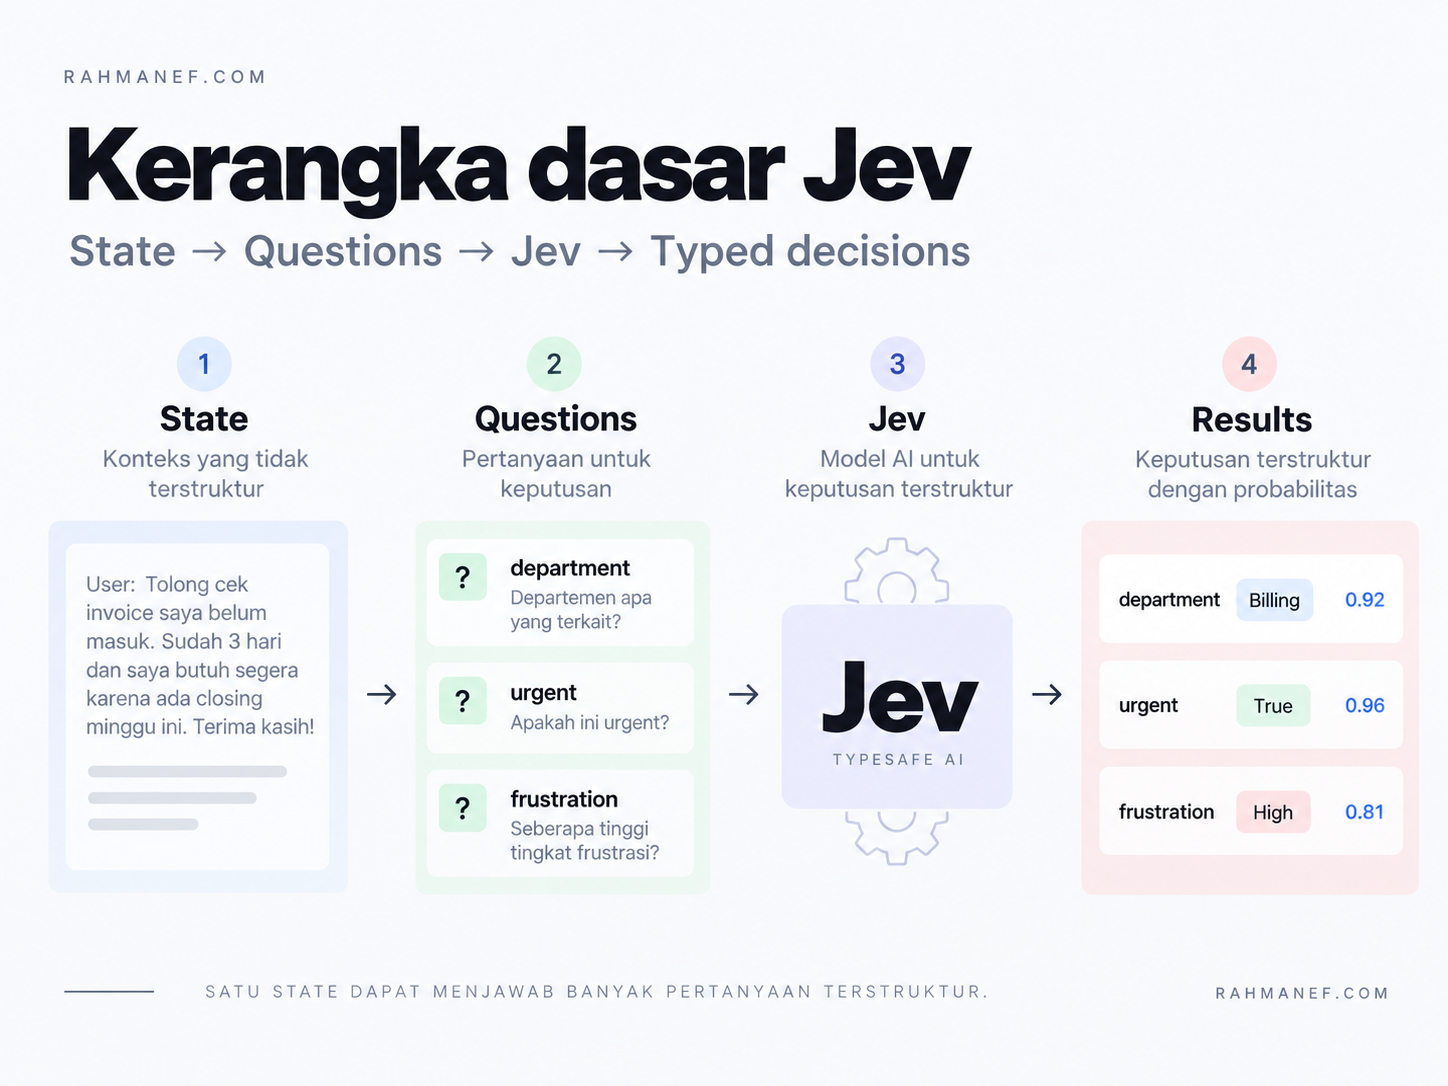
Misalnya state-nya adalah tiket customer support:
“Pelanggan mengatakan kartu kreditnya ditagih dua kali. Ia sudah menghubungi support kemarin dan meminta masalah ini diselesaikan sebelum tagihan berikutnya.”
Aplikasi kemudian menanyakan beberapa hal secara terstruktur:
department?urgent?frustration?
Menurut dokumentasi TypeSafe, pertanyaan dapat dicampur dalam satu request dan dievaluasi secara independen terhadap state yang sama.
#Choice, Score, dan Noul
Dokumentasi Jev menyediakan tiga primitive utama untuk membentuk pertanyaan.
Choice dipakai ketika hasil harus dipilih dari daftar opsi.
Contoh hasil: department → Billing.
Model juga mengembalikan distribusi probabilitas dan confidence untuk pilihan tersebut.
Score dipakai untuk menilai posisi pada skala yang ditentukan developer.
Contoh konseptual: frustration → 0.81.
Aplikasi dapat memetakan nilai tersebut ke kategori seperti Low, Medium, atau High jika memang diperlukan oleh produk.
Noul mengembalikan probabilitas antara 0 dan 1 untuk sebuah pernyataan atau kondisi.
Contoh hasil: urgent → 0.92.
Perlu dibedakan antara output model dan keputusan aplikasi. Noul tidak secara langsung mengembalikan boolean True atau False. Software bisa membuat aturan, misalnya urgent = true jika probabilitas lebih besar dari 0,80.
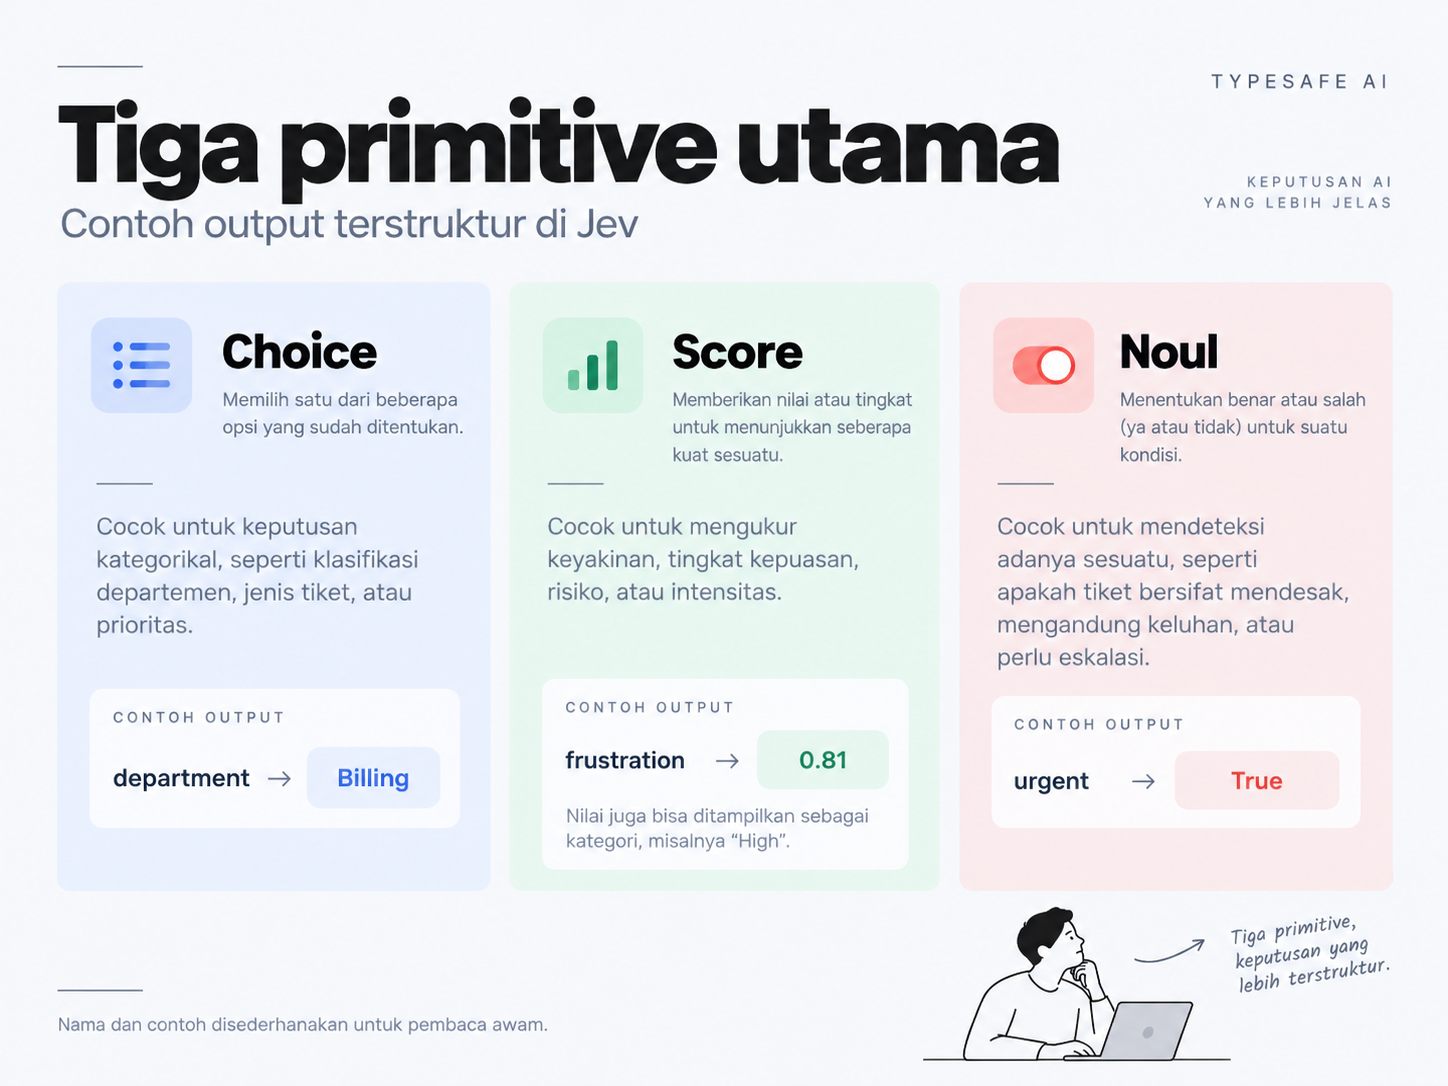
Pemisahan ini penting karena model memberikan penilaian probabilistik, sedangkan aturan bisnis tetap berada di code.
#Jev vs LLM biasa
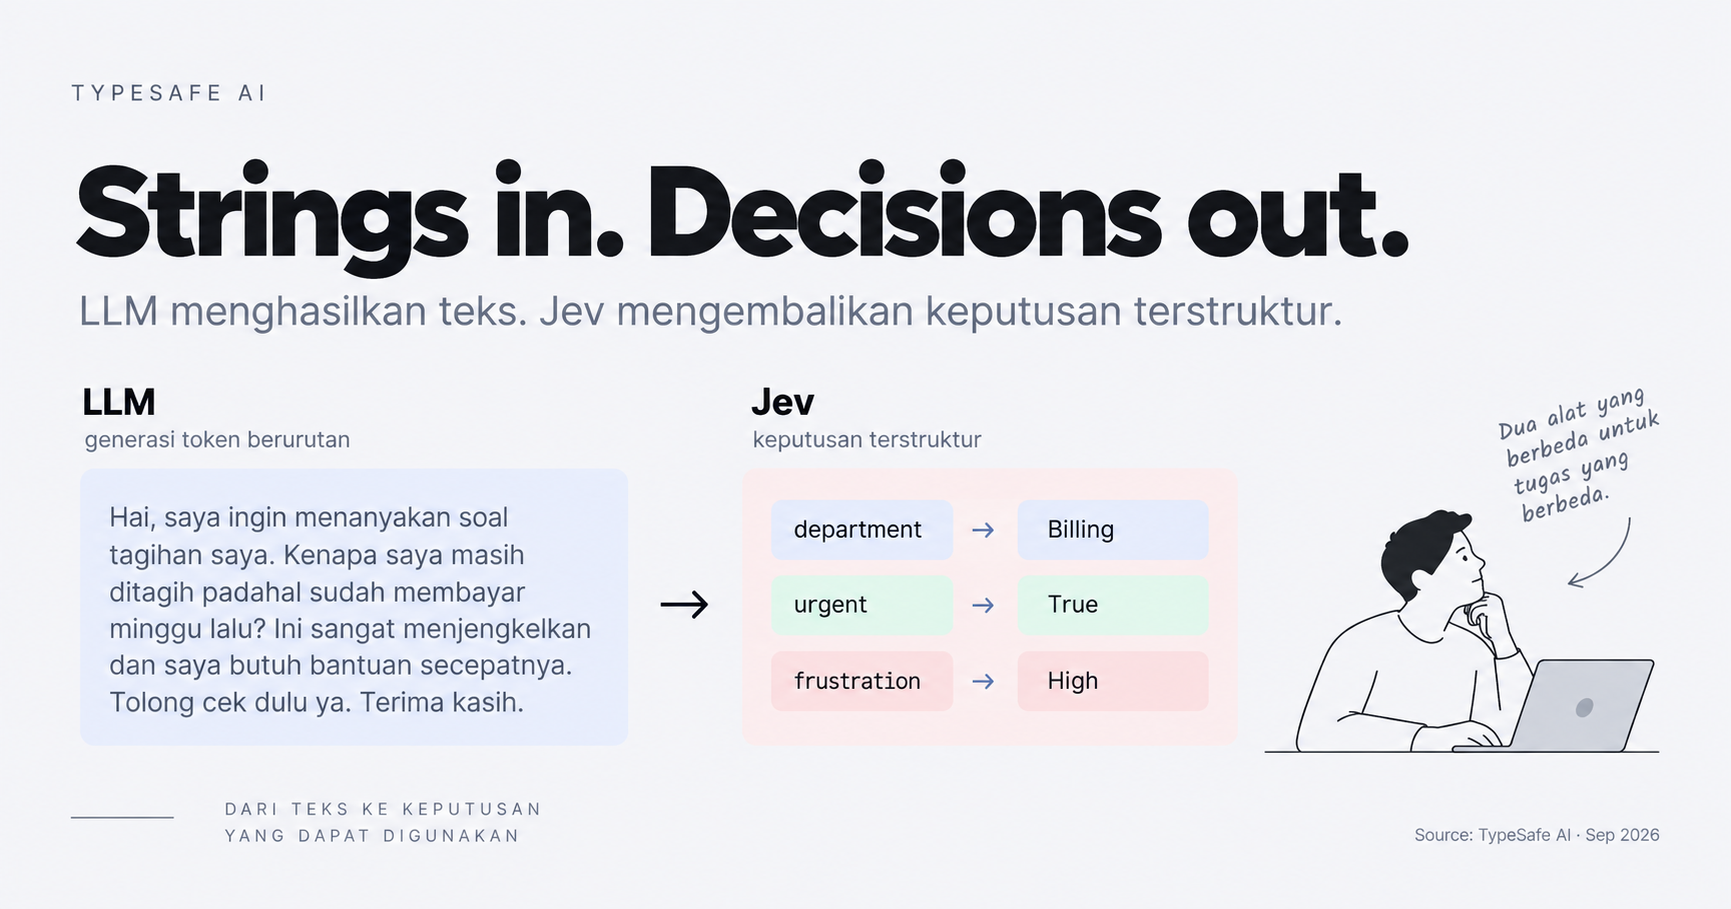
Perbandingan yang lebih berguna bukan “mana yang lebih pintar?”, tetapi pekerjaan apa yang sedang dilakukan?
| Aspek | Jev | LLM |
|---|---|---|
| Tujuan utama | Keputusan sempit dan terstruktur | Generasi, reasoning, dialog |
| Output | Typed decision, probability, confidence | Teks/token, termasuk structured output bila diminta |
| Pertanyaan | Opsi atau skala ditentukan sebelumnya | Dapat sangat terbuka |
| Pola penggunaan | Classification, scoring, routing, gating | Menulis, menjelaskan, meringkas, coding, analisis |
| Fleksibilitas | Lebih sempit | Lebih umum |
| Kekuatan | Mudah dimasukkan ke alur software yang membutuhkan keputusan | Kuat untuk konteks terbuka dan keluaran yang belum diketahui bentuknya |
| Keterbatasan | Tidak ditujukan untuk menghasilkan penjelasan panjang atau konten bebas | Structured output tetap memerlukan perhatian pada validasi, biaya, latency, dan reliability workflow |
Perbedaan mekanismenya juga relevan. LLM generatif biasanya membuat output secara autoregresif: token berikutnya bergantung pada token sebelumnya. TypeSafe mendeskripsikan Jev sebagai model yang mengevaluasi pertanyaan terstruktur secara paralel dan tidak melakukan string generation seperti chatbot.
Namun output terstruktur tidak otomatis berarti keputusan selalu benar. Schema dapat mencegah bentuk output yang tidak valid, tetapi nilai yang dipilih model tetap bisa keliru.
#Contoh implementasi: customer support
Customer support adalah contoh yang mudah dibayangkan karena satu pesan pelanggan dapat membutuhkan beberapa keputusan sekaligus.
Input:
“Saya ditagih dua kali untuk transaksi yang sama. Saya sudah melapor kemarin dan belum ada solusi. Tolong selesaikan sebelum kartu saya ditagih lagi.”
Jev dapat dipakai untuk mengevaluasi:
department → Billingurgent → 0.92frustration → 0.81
Lalu software menerapkan aturan bisnis:
if (department === "Billing") {
  routeTo("billing-team");
}

if (urgentProbability > 0.8) {
  priority = "high";
}

if (frustrationScore > threshold) {
  requireHumanReview = true;
}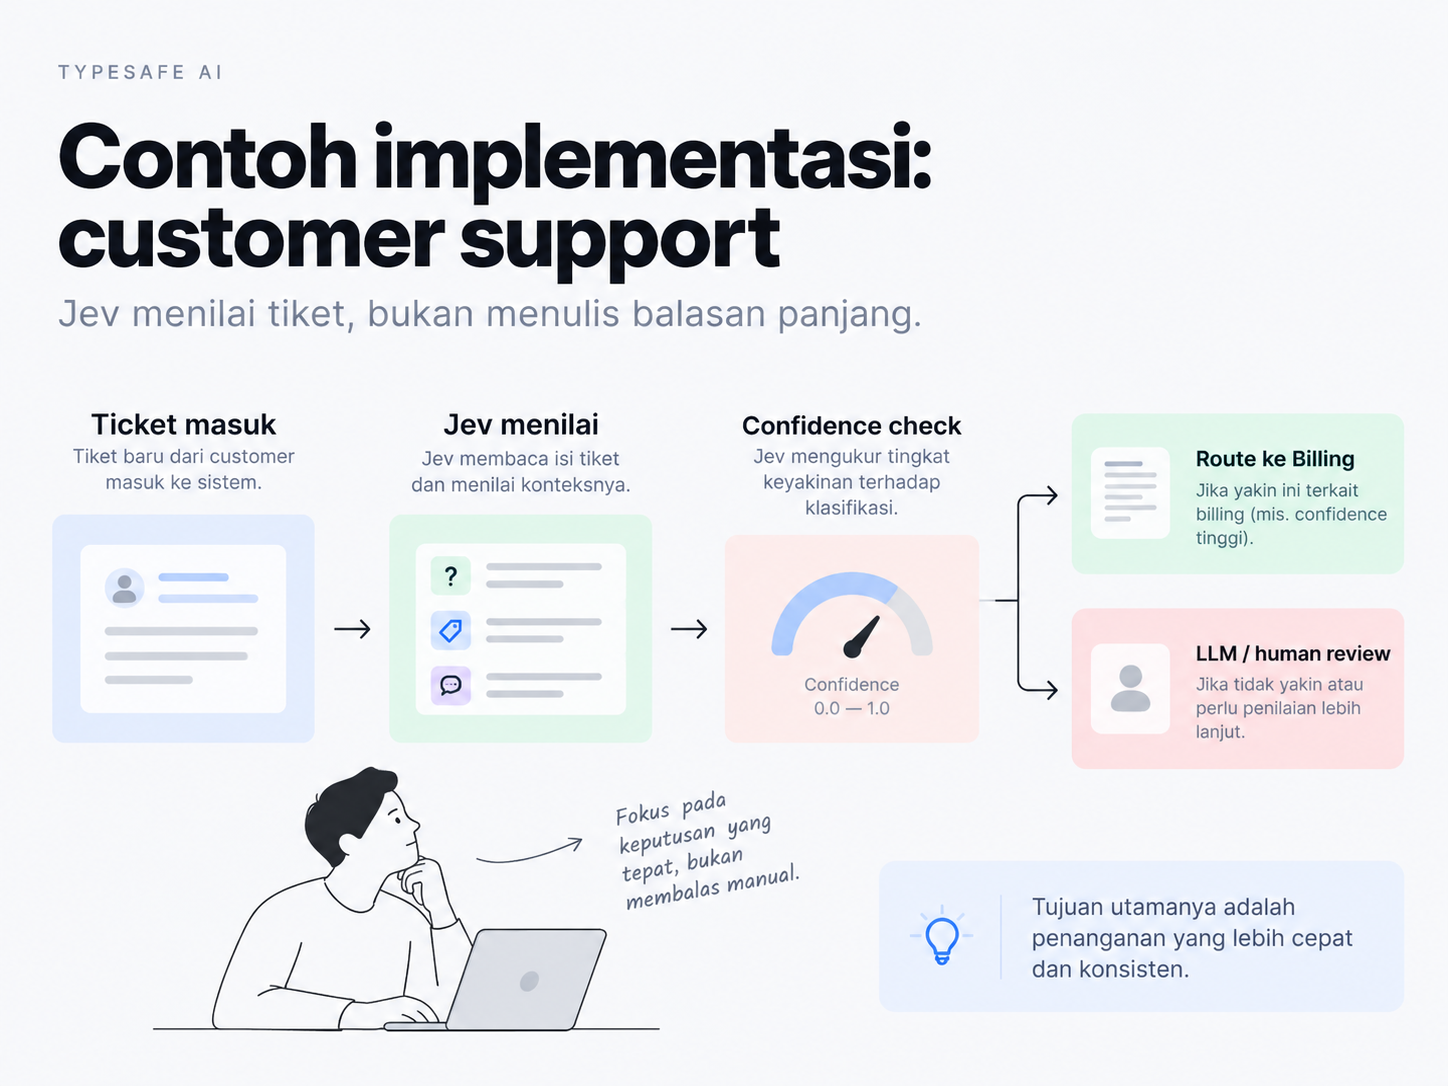
Di sini Jev tidak menulis balasan untuk pelanggan. Ia membantu aplikasi menjawab beberapa pertanyaan kecil yang kemudian dipakai oleh sistem routing.
Jika setelah routing kita ingin membuat draft balasan yang sopan dan mempertimbangkan riwayat percakapan, LLM justru lebih masuk akal.
#Jev tidak harus bekerja sendirian
Pola yang lebih realistis adalah menggabungkan Jev, code, LLM, dan human review.
Salah satu bentuknya:
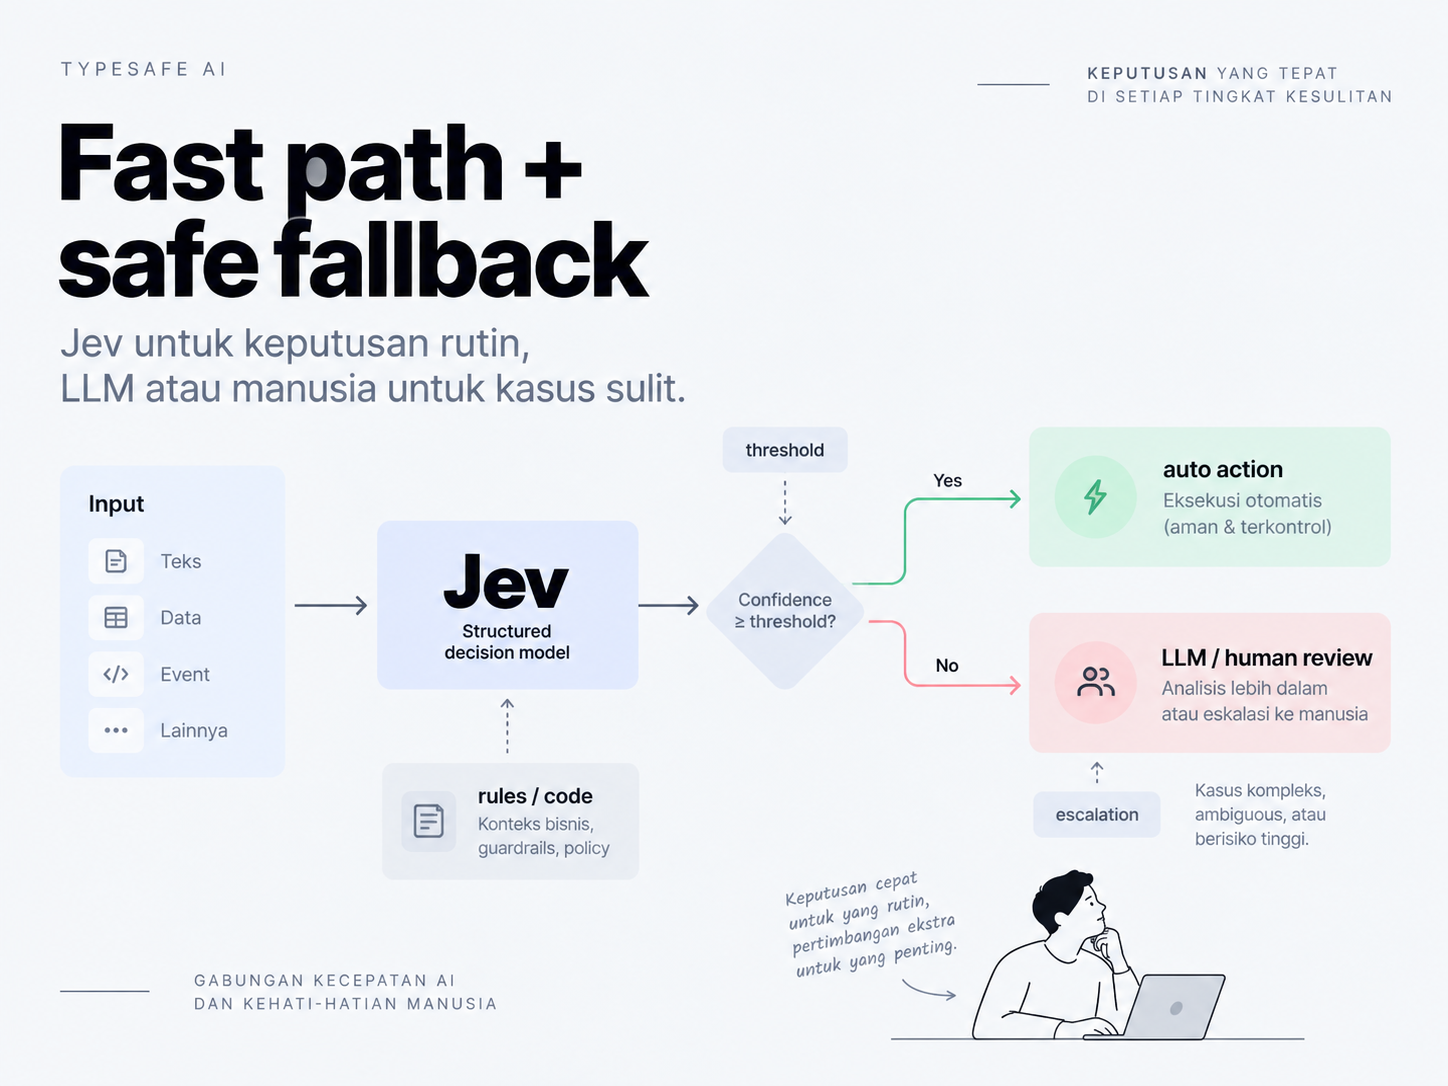
Contohnya pada fraud triage:
- Jev menilai kategori transaksi dan probabilitas risiko.
- Code memeriksa aturan yang pasti, misalnya limit transaksi, tanggal, status akun, atau permission.
- Kasus dengan confidence rendah dikirim ke model yang lebih umum atau manusia.
- Keputusan berisiko tinggi tetap membutuhkan policy dan audit trail.
Arsitektur seperti ini juga menghindari dua kesalahan umum: menyerahkan semua keputusan ke AI, atau memaksa LLM melakukan pekerjaan yang sebenarnya cukup diselesaikan dengan aturan deterministik.
#Kapan Jev cocok dipakai?
Jev masuk akal ketika beberapa kondisi berikut terpenuhi:
- bentuk keputusan sudah diketahui;
- pilihan jawaban dapat didefinisikan sebelumnya;
- aplikasi membutuhkan banyak micro-decisions;
- output harus mudah dikonsumsi code;
- probabilitas atau confidence berguna untuk membuat fallback;
- workflow membutuhkan routing, classification, scoring, atau gating.
Contoh lain selain customer support:
- memilih queue untuk email masuk;
- menilai kemungkinan sebuah lead relevan;
- menentukan kategori dokumen;
- memberi score pada feedback;
- memilih tool berikutnya pada agent workflow;
- menilai apakah suatu item perlu human review.
#Kapan LLM masih lebih cocok?
LLM lebih tepat ketika hasil yang diinginkan bersifat terbuka.
Misalnya:
- menulis email;
- menjelaskan error;
- meringkas dokumen panjang;
- membuat atau mereview kode;
- berdialog dengan pengguna;
- menyusun rencana dari instruksi yang ambigu;
- melakukan reasoning yang membutuhkan banyak langkah dan penjelasan.
Jev tidak perlu dipaksa menjadi chatbot, dan LLM tidak perlu dipaksa menjadi classifier untuk setiap keputusan kecil.
#Batasan dan penggunaan yang aman
Typed output menyelesaikan sebagian masalah integrasi, bukan seluruh masalah reliability.
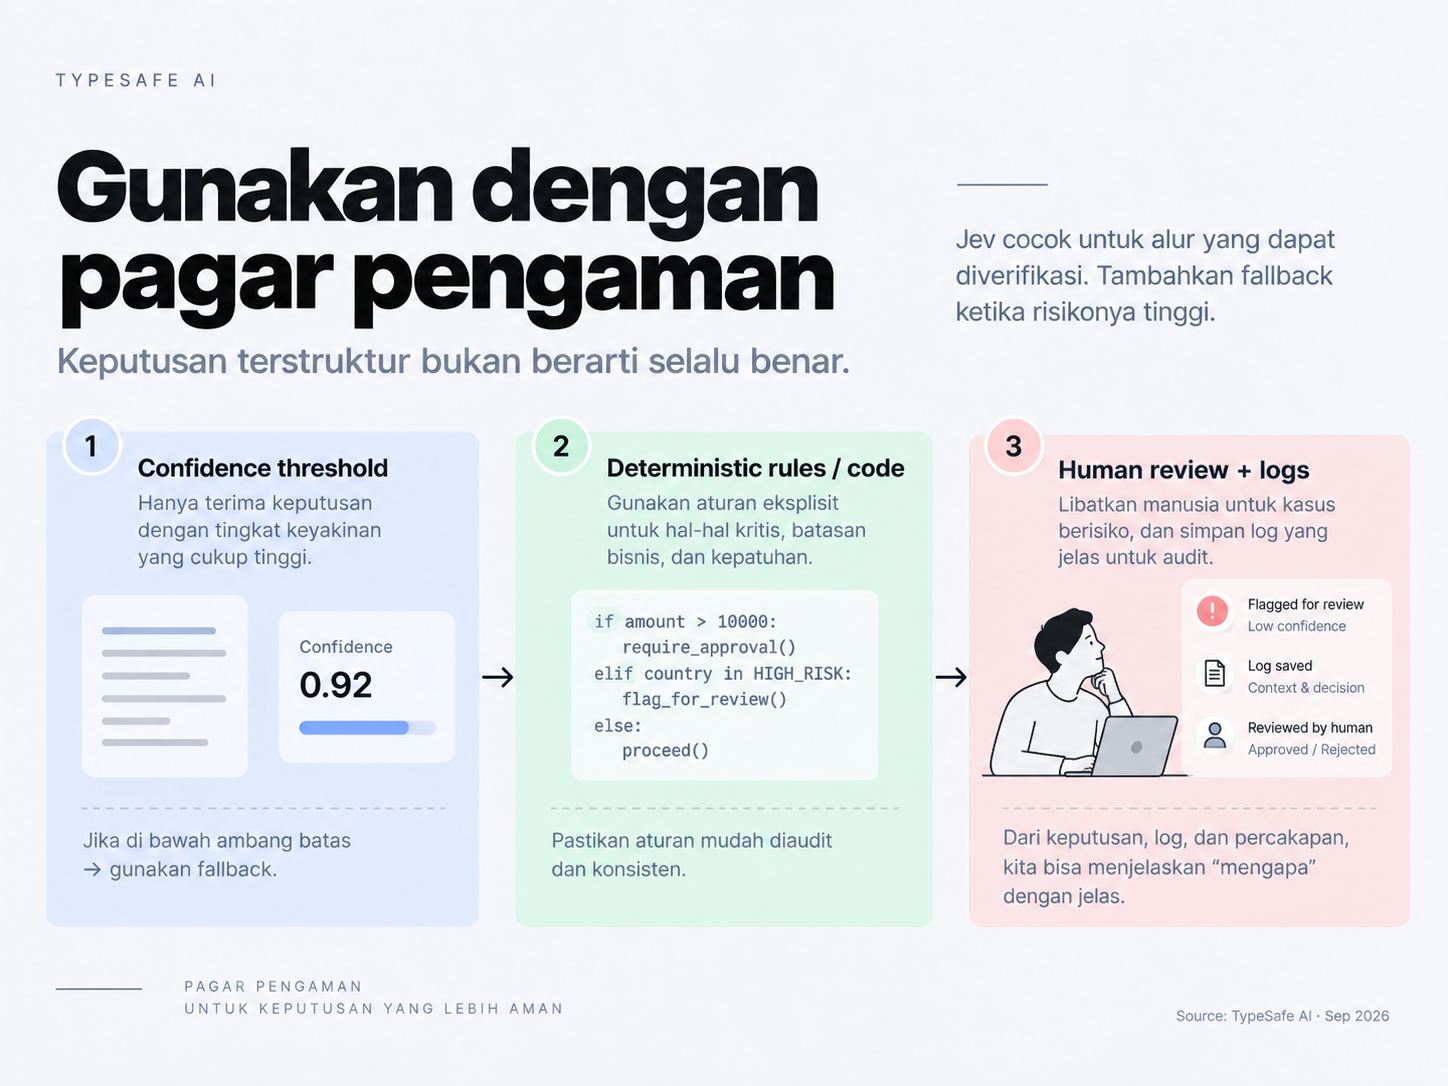
Beberapa hal yang perlu diperhatikan:
1. Keputusan terstruktur tetap bisa salah.
Model dapat mengembalikan nilai yang sesuai schema tetapi salah secara substantif. Karena itu accuracy pada data produk sendiri lebih penting daripada sekadar memastikan JSON valid.
2. Confidence harus diuji pada data nyata.
Threshold seperti 0,80 bukan angka universal. Kalibrasikan dengan data berlabel, ukur false positive dan false negative, lalu pilih threshold sesuai biaya kesalahan di workflow tersebut.
3. Pertanyaan yang kabur menghasilkan sistem yang kabur.
Dokumentasi TypeSafe mendorong pertanyaan yang atomic. Jika satu pertanyaan sebenarnya mencampur beberapa judgment, lebih aman memecahnya lalu menggabungkan hasil di code.
4. Aturan pasti tetap lebih baik dikerjakan oleh code.
Arithmetic, perbandingan tanggal, permission, limit transaksi, dan policy eksplisit sebaiknya diverifikasi secara deterministik ketika memungkinkan.
5. High-risk workflow membutuhkan guardrail tambahan.
Untuk keputusan finansial, legal, keselamatan, atau keputusan yang berdampak besar pada manusia, gunakan logging, audit trail, rules, threshold konservatif, dan human review yang sesuai.
6. Evaluasi vendor bukan pengganti benchmark aplikasi sendiri.
TypeSafe menyediakan eval yang berguna untuk memahami karakter model, tetapi latency, cost, dan accuracy produksi akan dipengaruhi data, lokasi, request pattern, serta desain pertanyaan Anda sendiri.
#Apakah Jev menggantikan LLM?
Tidak secara umum.
Cara yang lebih berguna untuk melihatnya:
Jev menarik karena menunjukkan bahwa “memakai AI” tidak selalu berarti menaruh chatbot di depan pengguna. Model dapat bekerja sebagai komponen kecil di belakang layar, selama tugasnya jelas dan sistem tetap menentukan guardrail-nya.
#Video untuk memahami Jev lebih lanjut
Tiga video berikut membahas Jev dari sudut yang berbeda: breakdown teknis, demo, dan kritik terhadap klaim benchmark.


#Referensi
#Sumber primer
- TypeSafe AI — Introducing System One Models and Jev
- TypeSafe AI — Documentation: Introduction
- TypeSafe AI — Evals
- TypeSafe AI — Customer Service Eval
- Vercel — TypeSafe AI Jev now available on AI Gateway
#Sumber sekunder
- DataCamp — Jev: TypeSafe's System One Model Explained
- Flavio Copes — A deep dive into Jev, TypeSafe's System One model
Artikel ini sengaja membedakan klaim vendor, dokumentasi mekanisme, dan rekomendasi arsitektur. Untuk keputusan implementasi, uji Jev pada data dan failure mode aplikasi Anda sendiri.